Resumen
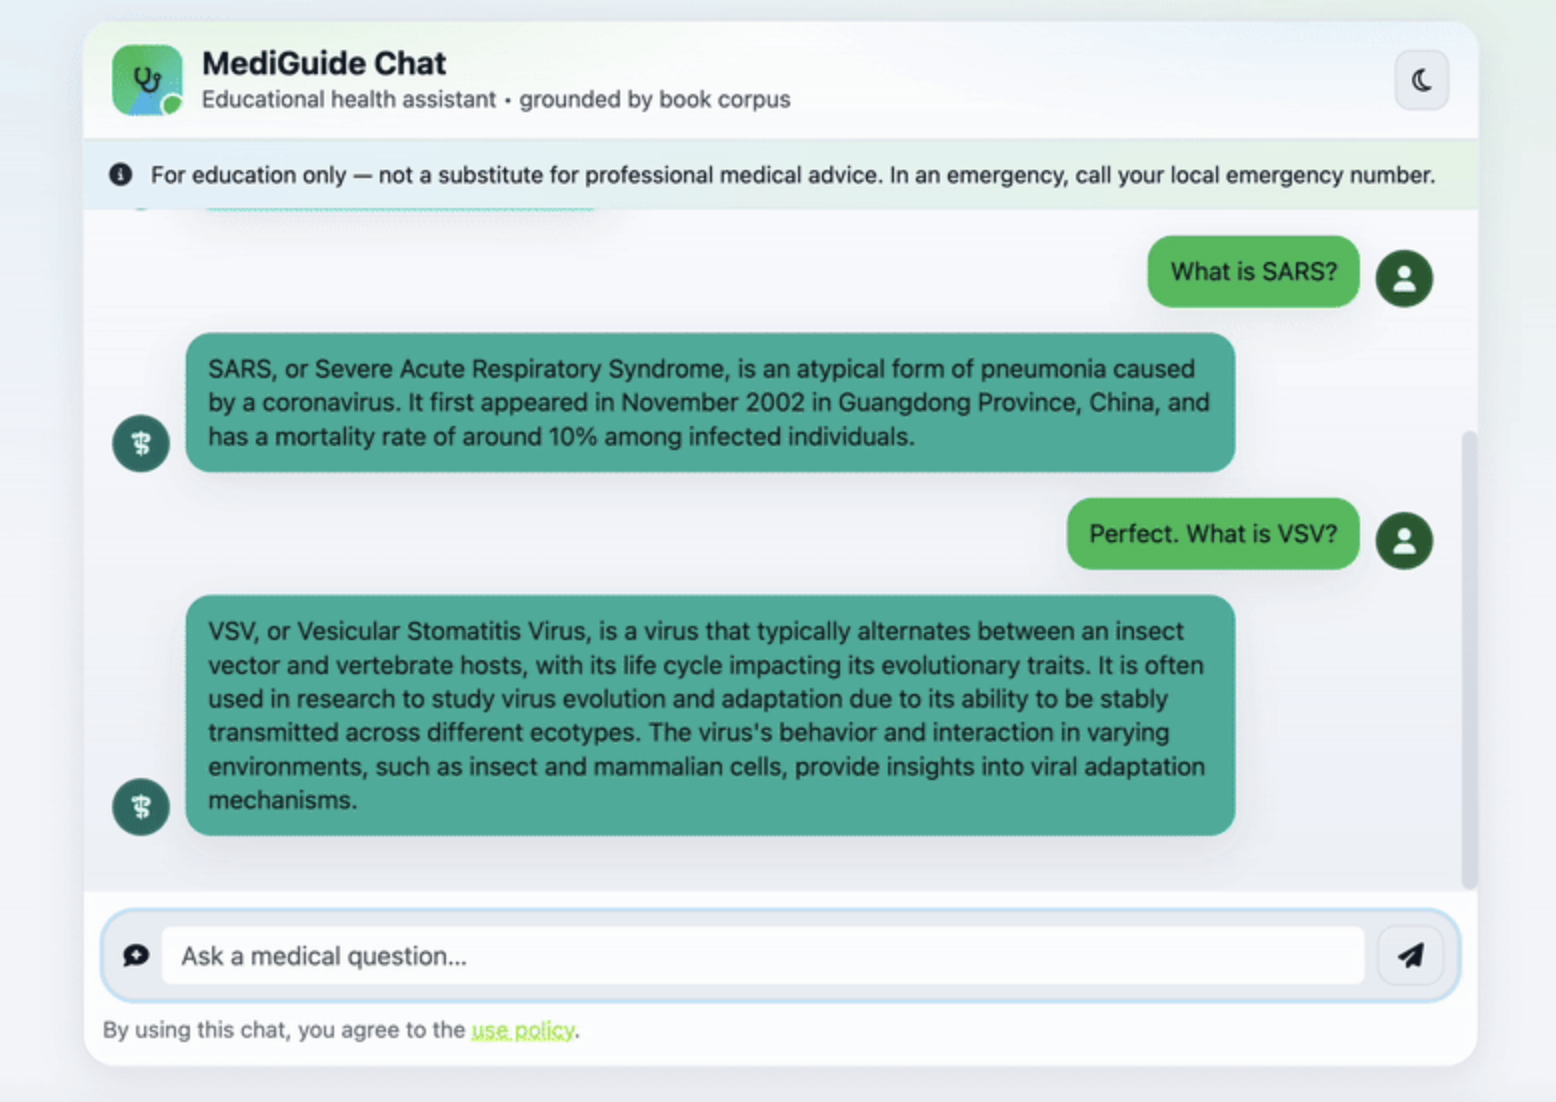
Implementé un chatbot con generación aumentada por recuperación como proyecto educativo: GPT-4o responde preguntas usando fragmentos recuperados de un libro de referencia médica indexado en Pinecone.
El proyecto cubre el recorrido desde la ingesta de documentos hasta una app Flask en contenedor, con un workflow de GitHub Actions que construye la imagen Docker, la sube a Amazon ECR y la ejecuta en una instancia EC2.
Enfoque
El prompt de sistema le indica al modelo que responda con el contexto recuperado, que diga cuándo no sabe algo y que limite sus respuestas a tres oraciones.
Arquitectura
Ingesta
DirectoryLoader y PyPDFLoader leen el PDF de origen, y cada página conserva solo su fuente como metadato.
Fragmentación
RecursiveCharacterTextSplitter con fragmentos de 500 caracteres y una superposición de 20.
Embeddings y base vectorial
Embeddings all-MiniLM-L6-v2 de HuggingFace (384 dimensiones) guardados en un índice serverless de Pinecone con similitud coseno.
Recuperación y generación
La búsqueda por similitud devuelve los 3 fragmentos más cercanos y una cadena de recuperación de LangChain se los pasa a GPT-4o junto con el prompt de sistema.
App y despliegue
Flask sirve la página de chat y un endpoint de mensajes. GitHub Actions construye la imagen Docker, la sube a Amazon ECR y la ejecuta en EC2 mediante un runner propio.
Tecnología
- Python
- LangChain
- HuggingFace
- Pinecone
- GPT-4o
- Flask
- Docker
- AWS ECR
- AWS EC2
- GitHub Actions
Limitaciones
- No hay evaluación de la calidad de la recuperación ni de las respuestas.
- Las respuestas dependen de una sola fuente de referencia, que no se redistribuye con el repositorio.
- Los fragmentos recuperados no se muestran al usuario como citas.
- No tiene validación clínica. No está pensado para diagnósticos ni recomendaciones de tratamiento y no es software de salud en producción.
Código e implementación
Explora el repositorio.
Revisa el código y la documentación disponible del proyecto en GitHub.