Resumen
Desarrollé un modelo de churn sobre el dataset público Bank Customer Churn de Kaggle (10.000 clientes) y lo conecté con una decisión de retención. En lugar de elegir el modelo con mejor ROC-AUC, el proyecto lo selecciona y lo evalúa según el beneficio de la campaña que recomienda.
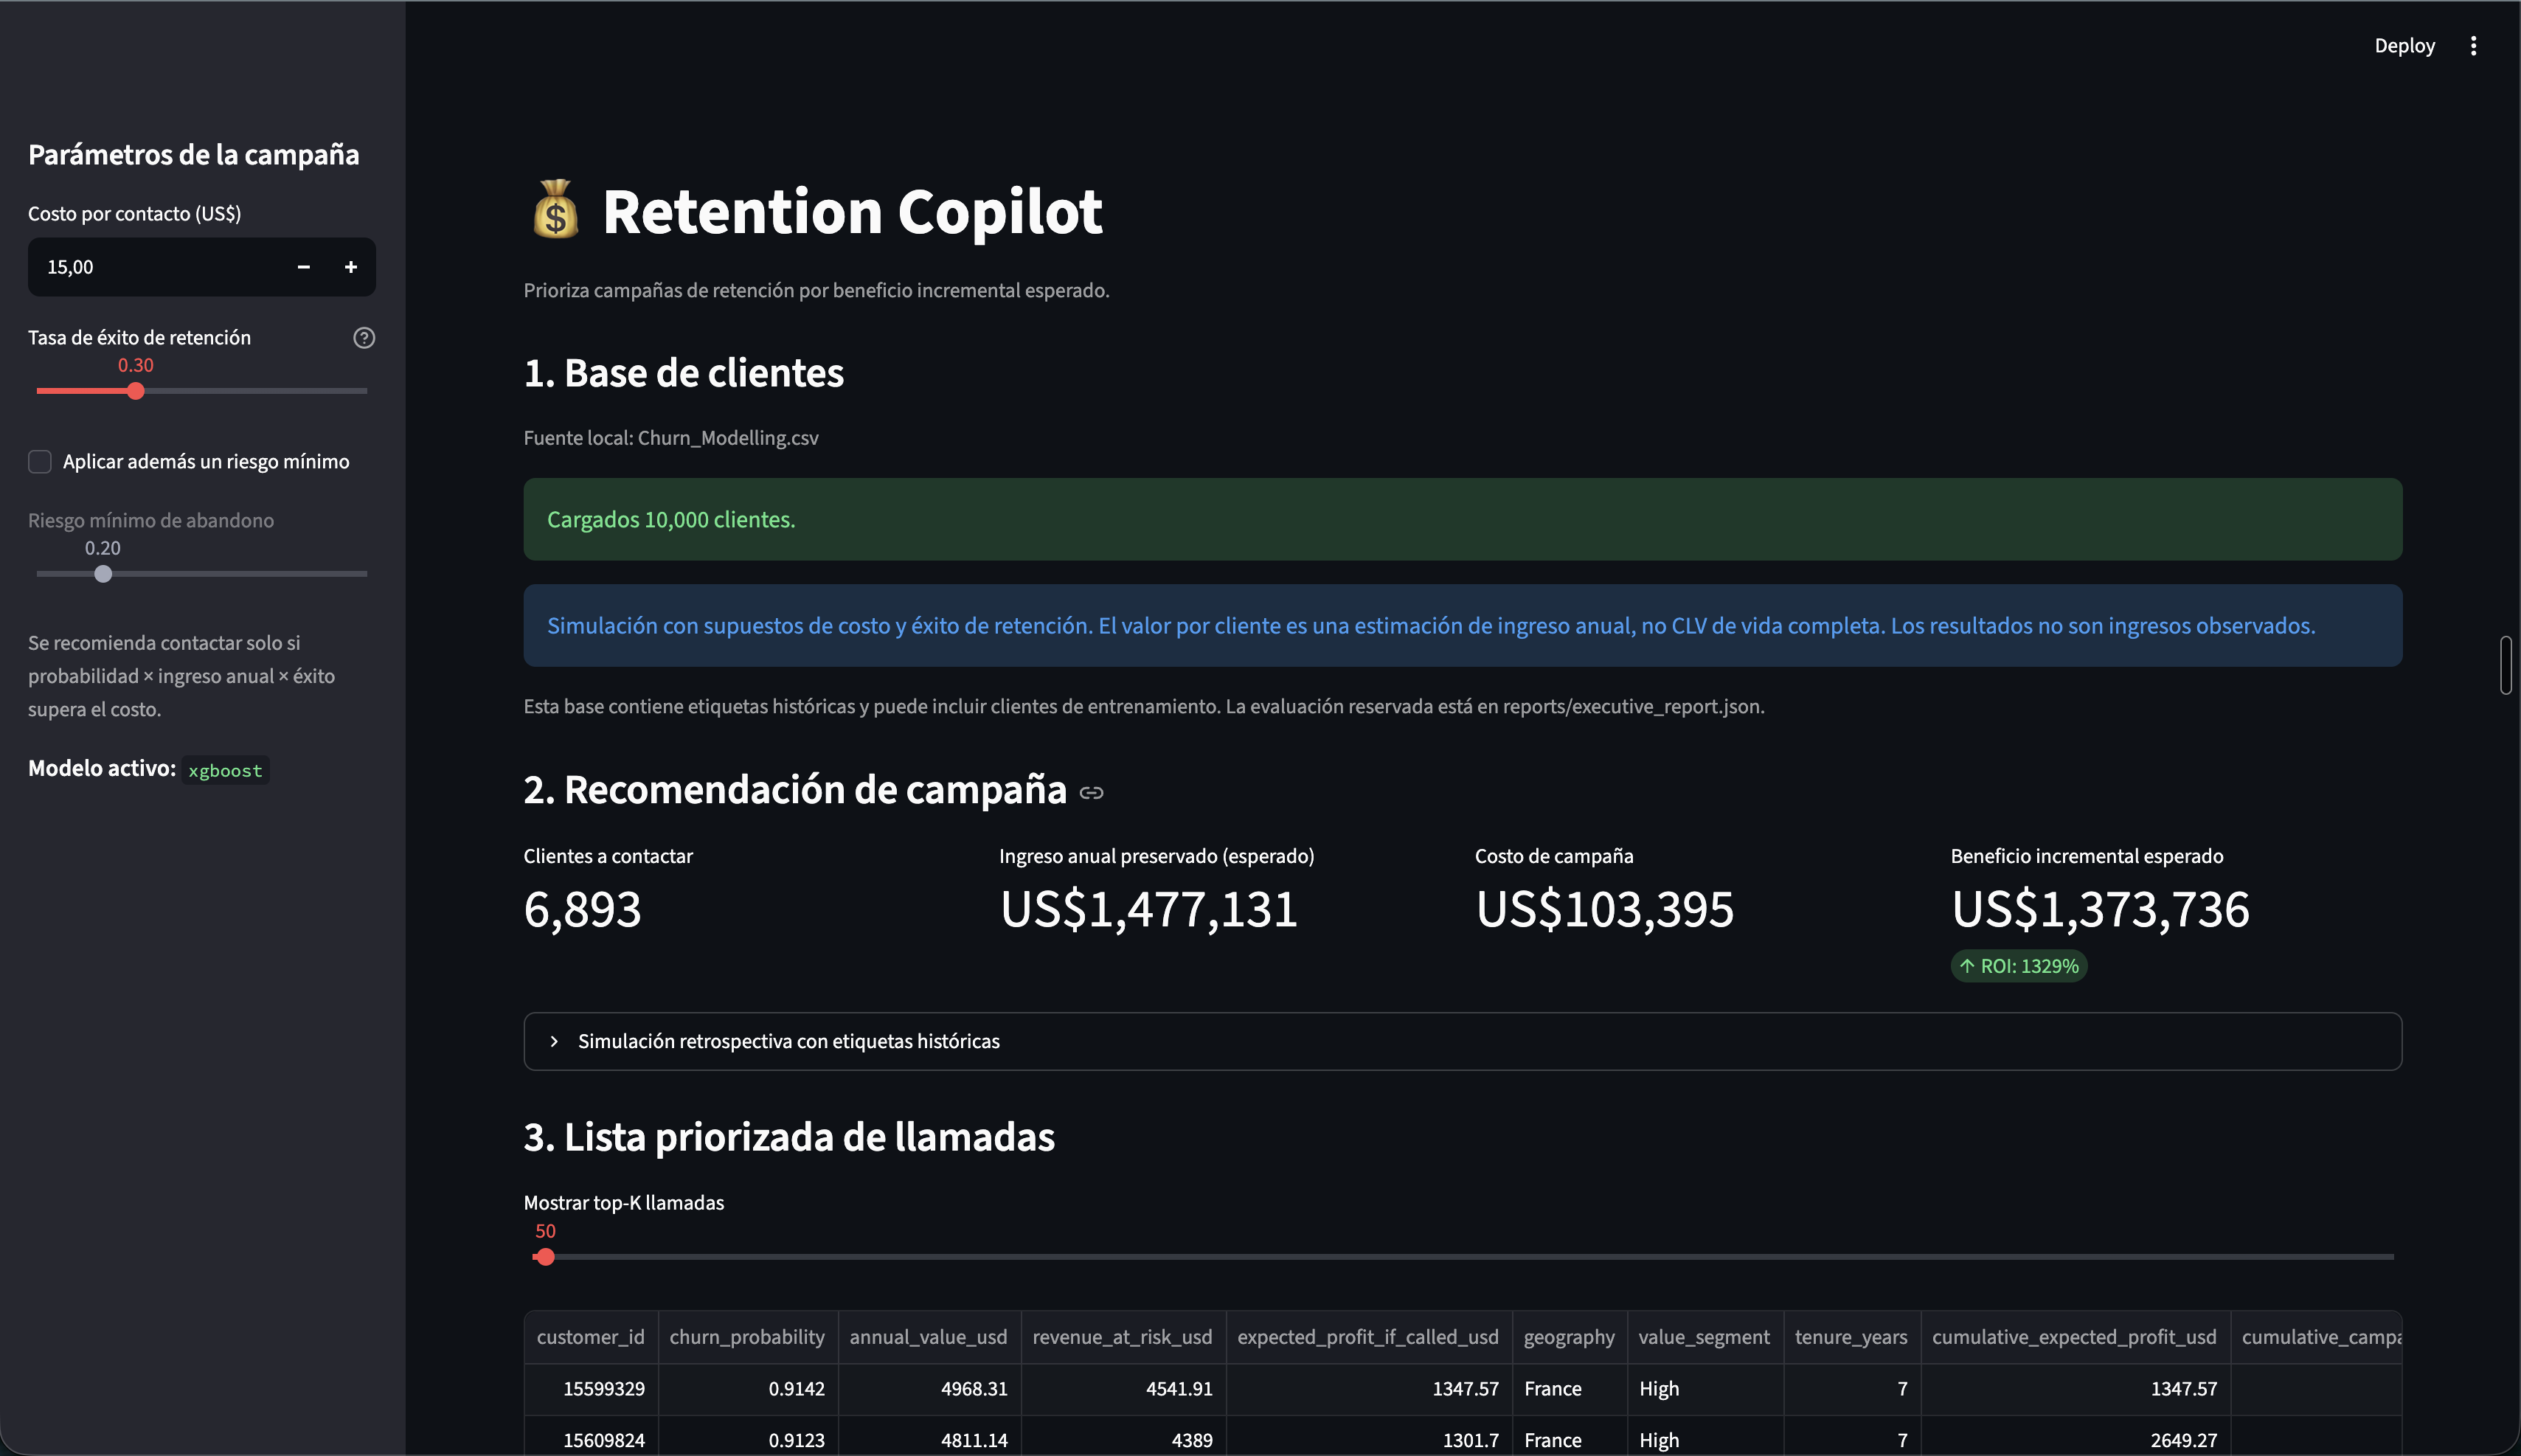
Una app en Streamlit puntúa la base de clientes y recalcula la lista de contactos cuando cambian el costo de la campaña o la tasa de éxito supuesta. Todas las cifras financieras son simulaciones bajo supuestos explícitos, no ingresos observados de un banco.
Problema
Ordenar a los clientes por probabilidad de abandono ignora cuánto valor podría preservar una llamada, y un umbral fijo de 0,5 no responde a cambios en el costo o la eficacia de la campaña. La pregunta es a qué clientes contactar para maximizar el beneficio esperado de una campaña de retención.
Enfoque
Estimé el valor anual de cada cliente como 0,025 × saldo + 80 × productos + 150 × indicador de tarjeta de crédito, con el saldo limitado al percentil 99 del conjunto de entrenamiento. Los coeficientes son supuestos ilustrativos y el resultado es ingreso anual, no el valor de vida completo del cliente.
Un cliente se recomienda para contacto solo cuando P(abandono) × valor × tasa de éxito − costo del contacto es positivo, y las recomendaciones se ordenan por ese beneficio esperado. Con una tasa de éxito de cero, el sistema recomienda correctamente no hacer campaña.
Metodología
División estratificada 60/20/20
6.000 clientes de entrenamiento, 2.000 de validación y 2.000 de prueba, reproducible con una semilla fija.
Tres candidatos calibrados
Regresión logística, Random Forest y XGBoost, cada uno con calibración sigmoide de 3 folds ajustada dentro del entrenamiento. La imputación, los límites p99, el escalado y la codificación se ajustan dentro de cada fold.
Selección por resultado económico
Se elige el modelo cuya política de contacto logra el mayor beneficio simulado en validación. No se ajusta ningún umbral sobre el conjunto de prueba.
Evaluación reservada con líneas base
El modelo elegido se evalúa una sola vez en prueba frente a no actuar, contactar a todos y una selección aleatoria del mismo tamaño (con su esperanza analítica).
Pipeline con pruebas
17 pruebas unitarias con datos sintéticos cubren la división, las transformaciones, las definiciones de beneficio y la app; GitHub Actions las ejecuta en Python 3.11.
Resultados / Hallazgos clave
Los resultados financieros son simulaciones bajo supuestos explícitos (US$15 por contacto, 30% de éxito de retención). No son ingresos observados de un banco ni efectos causales, y el valor anual del cliente no es un CLV completo.
- clientes analizados
- 10.000
- ROC-AUC (conjunto de prueba)
- 0,855
- Average Precision (conjunto de prueba)
- 0,698
- menos contactos que contactar a todos
- 31,5%
- más de beneficio incremental simulado que contactar a todos
- US$6.405
| Política | Contactos | Costo | Beneficio incremental simulado |
|---|---|---|---|
| No actuar | 0 | US$0 | US$0 |
| Contactar a todos | 2.000 | US$30.000 | US$271.627,87 |
| Azar, misma cobertura (esperanza) | 1.370 | US$20.550 | US$186.065,09 |
| XGBoost + política económica | 1.370 | US$20.550 | US$278.032,87 |
- La política contacta a 1.370 de los 2.000 clientes de prueba, 630 menos que contactar a todos, con US$6.405 más de beneficio simulado.
- Frente a una selección aleatoria del mismo tamaño, suma US$91.967,78 de beneficio simulado esperado.
- Brier score en prueba: 0,104.
- XGBoost superó a Random Forest por solo unos US$54 de beneficio simulado en validación. Esa diferencia es demasiado pequeña para afirmar que un modelo es mejor: los resultados vienen de una única partición fija y sin intervalos de confianza.
Tecnología
- Python
- pandas
- NumPy
- Scikit-learn
- XGBoost
- Streamlit
- GitHub Actions
Limitaciones
- No hay datos de intervención: el éxito de retención es una tasa supuesta, no una estimación causal. El proyecto predice abandono y simula decisiones; no demuestra que una llamada cause la retención.
- El valor anual omite el horizonte de vida, el descuento, los costos completos y las diferencias entre ofertas.
- La división es aleatoria, así que no demuestra estabilidad en el tiempo ni generalización a otro banco.
- La calibración se ajusta con validación cruzada, pero aún necesita evaluación por segmentos y fuera de muestra.
- El modelo usa geografía y género, y no se ha hecho una evaluación de equidad.
- La app es local, sin autenticación ni controles para una base de clientes real.
Código e implementación
Explora el repositorio.
Revisa el código y la documentación disponible del proyecto en GitHub.