Resumen
Analicé el desempeño de proveedores y marcas de un negocio minorista y mayorista a partir de registros de compras, ventas, precios y fletes. Los CSV en bruto se cargan en SQLite, se agregan en una tabla resumen por proveedor y marca, se analizan en Jupyter y se presentan en un dashboard de Power BI.
Los datos en bruto no se distribuyen con el repositorio, así que el proyecto incluye un contrato de datos que describe los archivos y columnas esperados.
Problema
¿Qué proveedores y marcas impulsan las ventas, el gasto en compras y la utilidad bruta? ¿Qué tan concentradas están las compras en los proveedores más grandes? ¿Qué productos combinan pocas ventas con márgenes altos, dónde hay capital inmovilizado en inventario de baja rotación y cómo se relaciona el tamaño del pedido con el costo unitario?
Enfoque
Construí el resumen con granularidad proveedor-marca usando CTEs en SQL. Los precios se cruzan por proveedor y marca, así que una marca vendida por varios proveedores no se cuenta dos veces.
Distribuí el flete de cada proveedor entre sus marcas en proporción a los dólares comprados, de modo que los montos asignados siguen sumando el total del proveedor. Una prueba de regresión con pytest verifica ambas reglas: compras sin duplicar y fletes que cuadran.
Definí cada métrica de forma explícita: utilidad bruta, utilidad neta después del flete asignado, margen, rotación de inventario y relación ventas/compras.
Metodología
Ingesta
Scripts en Python cargan los CSV en bruto a una base SQLite local y registran cada tabla.
Resumen proveedor-marca
Una consulta con CTEs combina compras, precios, ventas y facturas en una fila por proveedor y marca.
Limpieza y filtrado
Se estandarizan tipos y textos. Para el análisis se excluyen filas con utilidad o margen no positivos y sin ventas: quedan 8.564 de 10.692 filas.
Análisis exploratorio y estadístico
Distribuciones, valores atípicos, correlaciones, concentración de proveedores, rotación, intervalos de confianza del 95% y una prueba t sobre márgenes, en Jupyter.
Dashboard en Power BI
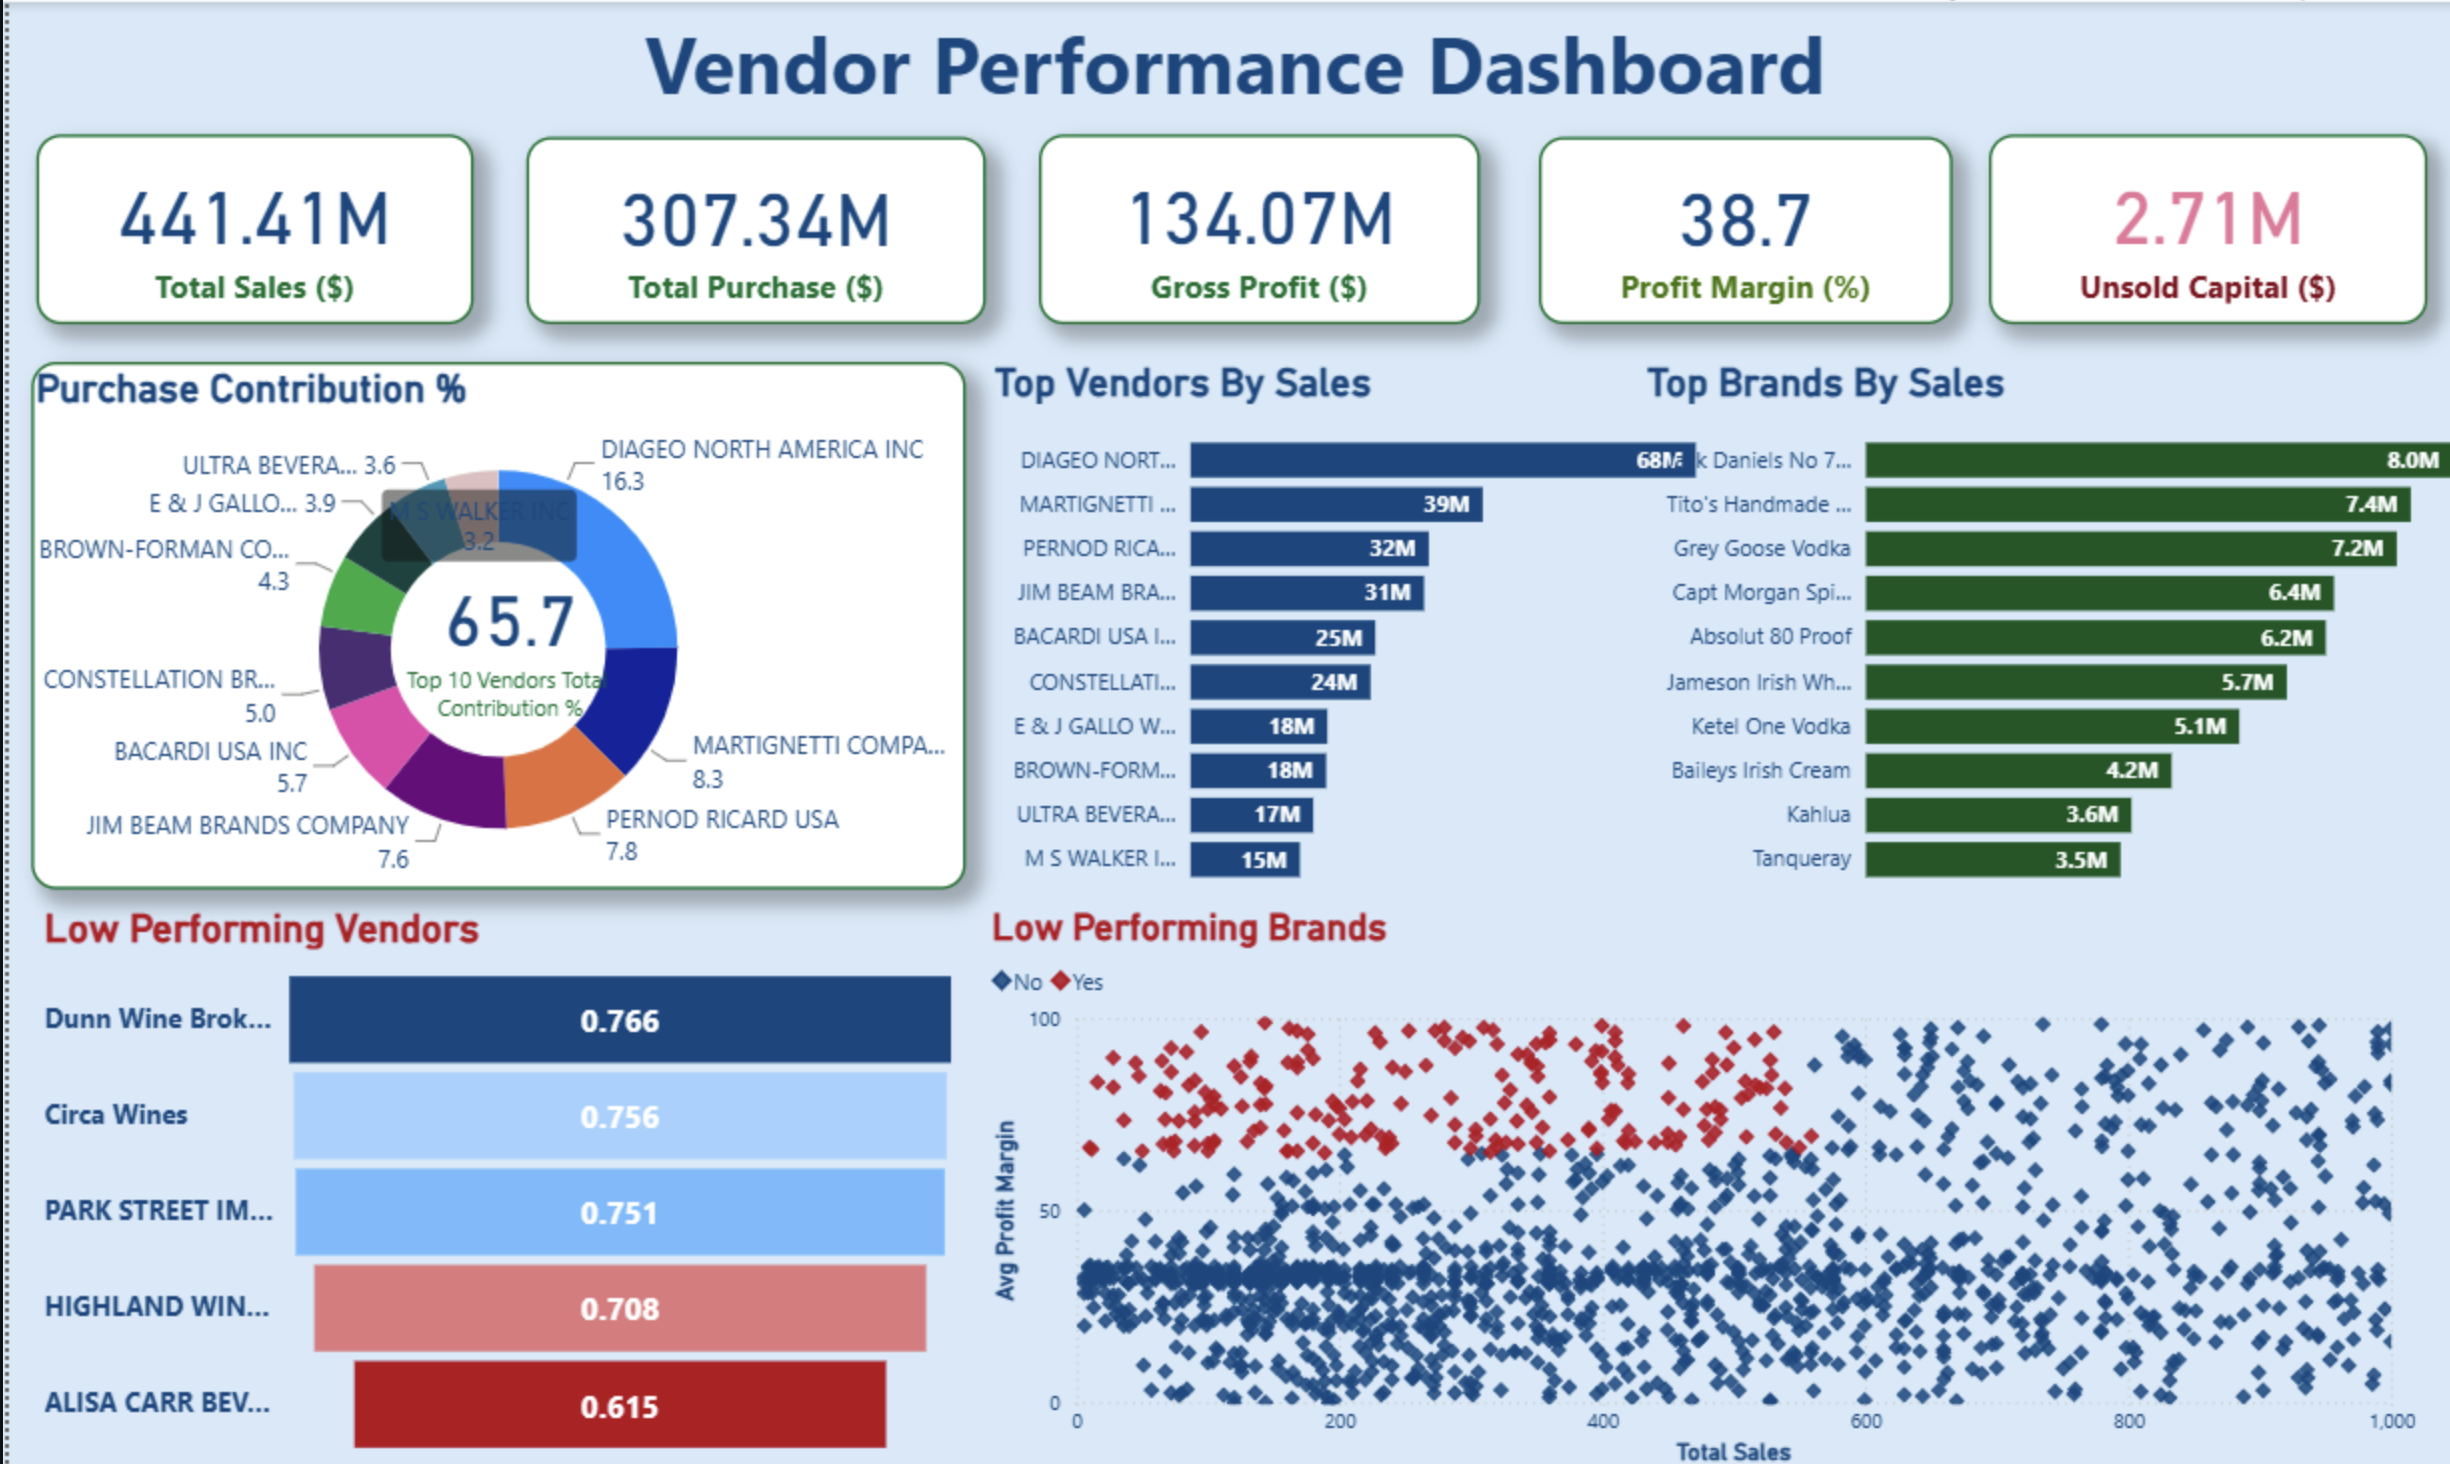
KPIs, contribución de compras por proveedor, principales proveedores y marcas por ventas, proveedores de baja rotación y marcas con pocas ventas y alto margen.
Resultados / Hallazgos clave
Estos hallazgos son descriptivos. Provienen del análisis en notebooks sobre los datos originales, que no se incluyen en el repositorio.
- de los dólares comprados viene de los 10 principales proveedores
- 65,69%
- de capital estimado inmovilizado en inventario sin vender
- US$2,71M
- filas proveedor-marca con pocas ventas y alto margen
- 198
- Los 10 principales proveedores concentran el 65,69% de los dólares comprados, así que las compras dependen de un grupo pequeño de proveedores.
- Se estiman unos US$2,71M inmovilizados en inventario sin vender (unidades compradas menos vendidas × precio de compra). Es una aproximación: habría que alinear los periodos de compras y ventas para tomarla como exacta.
- 198 filas proveedor-marca están en el 15% más bajo de ventas y en el 15% más alto de margen, los umbrales del proyecto para revisar precios o promociones.
- Las filas del cuartil superior de ventas tienen un margen promedio de 31,18% (IC 95%: 30,74–31,61%) frente a 41,57% (40,50–42,64%) en el cuartil inferior. La diferencia es estadísticamente significativa, pero describe a los dos grupos; no explica la causa.
- Los pedidos grandes muestran un costo unitario promedio menor que los pequeños (US$10,78 frente a US$39,07 por unidad). Es una asociación que no controla por la mezcla de productos, no un ahorro medido.
Tecnología
- Python
- pandas
- SQLite
- SQL
- Jupyter
- Matplotlib
- Seaborn
- SciPy
- pytest
- Power BI
Limitaciones
- Sin los datos en bruto, las cifras no se pueden reproducir solo con el repositorio.
- Las correlaciones, las comparaciones entre grupos y los patrones por tamaño de pedido son descriptivos y no establecen causas.
- El inventario sin vender se estima con unidades compradas menos vendidas y supone periodos alineados.
- Los grupos de margen se definen sobre filas proveedor-marca por cuartil de ventas, no sobre proveedores completos.
Código e implementación
Explora el repositorio.
Revisa el código y la documentación disponible del proyecto en GitHub.